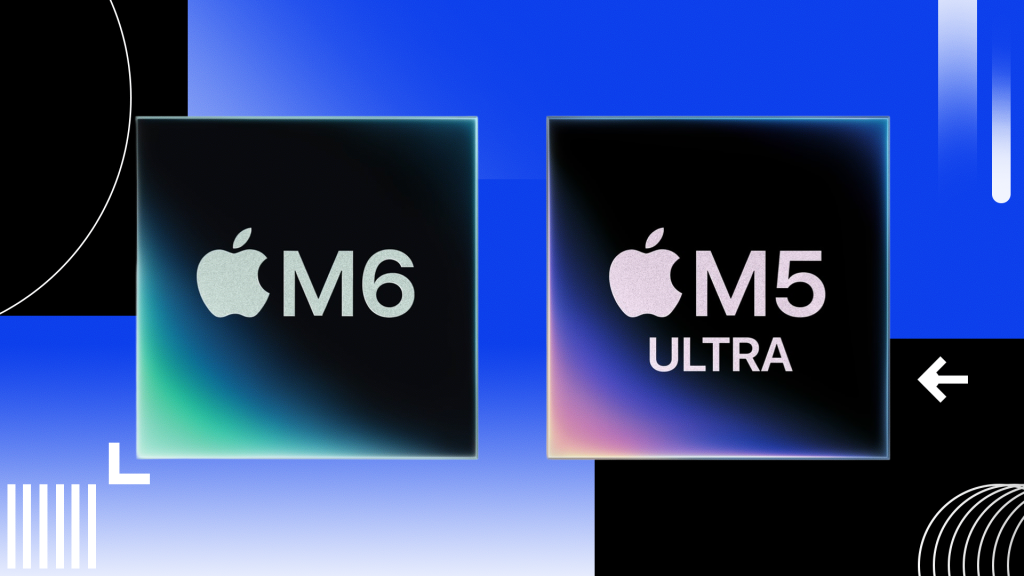
ปลดล็อกขีดจำกัดซิลิกอน! สรุปหมัดต่อหมัด Apple M6 (2nm) ปะทะ M5 Ultra (Quad-Die) ชิปตัวไหนคือขุมพลัง AI ที่แท้จริง?
Highlight
ศึกเปรียบเทียบชิปประมวลผลรุ่นใหม่ล่าสุดจาก Apple ระหว่าง M6 ชิปประเด็นร้อนระดับ 2nm ใน Mac mini ที่เน้นความประหยัดพลังงานและความเร็ว Single-threaded ระดับโลก ปะทะ M5 Ultra ขุมพลังระดับ Workstation ใน Mac Studio ที่ทลายขีดจำกัดด้วยสถาปัตยกรรม Quad-Die อัดแน่น 36-core CPU และ 80-core GPU มุ่งตอบโจทย์งาน AI แบบ Local Inference และการรันโมเดลระดับองค์กร
In Detail
สองทิศทางของซิลิกอนยุค Local AI
ในยุคที่การประมวลผล AI บนเครื่อง (Local AI) เข้ามามีบทบาทสำคัญในเวิร์กโฟลว์มากขึ้น Apple กำลังพัฒนาชิปออกเป็น 2 แนวทางที่ชัดเจน ด้านหนึ่งคือ M6 ที่เน้นการออกแบบชิปให้มีขนาดกะทัดรัด แต่ยังคงมอบประสิทธิภาพที่ทรงพลังสำหรับการใช้งานบนคอมพิวเตอร์ทั่วไป ขณะที่อีกด้านคือ M5 Ultra ที่นำสถาปัตยกรรมแบบ Multi-Die มาเพิ่มขีดความสามารถในการประมวลผล เพื่อรองรับงานที่ต้องการพลังสูงอย่างงานวิศวกรรมและการพัฒนาซอฟต์แวร์
2nm ประหยัดพลังงาน VS Quad-Die ทลายกำแพงซิลิกอน
- Apple M6: เป็นชิปตัวแรกของ Apple ที่ใช้กระบวนการผลิตระดับ 2 นาโนเมตร (2nm) ช่วยให้อัดแน่นทรานซิสเตอร์ได้มากขึ้นบน Die ขนาดเล็ก พร้อมโครงสร้าง CPU 12-core แบบผสม 3 Core Type (2 Super cores + 4 Performance cores + 6 Efficiency cores)
- Apple M5 Ultra: สร้างขึ้นโดยใช้เทคโนโลยี UltraFusion เชื่อมต่อชิป M5 Max แบบ Dual-die จำนวน 2 ตัวเข้าด้วยกัน จนเกิดเป็นสถาปัตยกรรม Quad-Die (รวม 4 ไดช์เป็น 1 ชิป) เพื่อให้ได้ขุมพลังรวมสูงสุด 36-core CPU และ 80-core GPU
เลือกตัวไหนให้เหมาะกับเวิร์กโฟลว์?
ความท้าทายของผู้ใช้คือการเลือกฮาร์ดแวร์ให้เหมาะกับลักษณะงาน เพราะงานแต่ละประเภทมีความต้องการที่แตกต่างกัน งานทั่วไปที่ทำงานแบบ Single-Threaded จะเน้นความเร็วต่อ Core ที่สูง ขณะที่งาน AI ขนาดใหญ่ งานกราฟิก 3D หรือการคำนวณทางวิทยาศาสตร์ อาจต้องการทั้งจำนวน Core ที่มากขึ้น แบนด์วิดท์หน่วยความจำที่สูง และ RAM ความจุขนาดใหญ่ เพื่อให้ทำงานได้อย่างราบรื่นและเต็มประสิทธิภาพ
ตารางเปรียบเทียบหมัดต่อหมัด
| คุณสมบัติ (Specification) | Apple M6 (Mac mini) | Apple M5 Ultra (Mac Studio) |
|---|---|---|
| กระบวนการผลิต (Node) | 2nm Process | Quad-Die Architecture (UltraFusion) |
| โครงสร้าง CPU | 12 Cores (2 Super + 4 P + 6 E) | สูงสุด 36 Cores (12 Super + 24 P) |
| แกนประมวลผลกราฟิก (GPU) | 12 Cores | สูงสุด 80 Cores |
| ระบบเร่งความเร็ว AI (NPU) | Dual 16-core Neural Engine + GPU Neural Accelerator | 32-core Neural Engine + GPU Neural Accelerator ทุก Core |
| Unified Memory Bandwidth | สูงสุด 170 GB/s | สูงสุด 1.2 TB/s |
| หน่วยความจำสูงสุด (RAM) | 32 GB | 512 GB |
| ความโดดเด่นในเวิร์กโฟลว์ | ประมวลผล Single-threaded เร็วที่สุดในโลก, ตอบสนองงานทั่วไปรวดเร็ว | โหลด LLM ทั้งโมเดลเข้า RAM, เรนเดอร์ 3D/8K ProRes หลายสตรีม |
คำแนะนำในการเลือกใช้งาน
หากคุณเป็นนักพัฒนาทั่วไป Creator ที่ต้องการคอมพิวเตอร์สำหรับการทำงานในแต่ละวัน ตัดต่อวิดีโอทั่วไป หรือใช้งาน AI โมเดลขนาดเล็ก M6 ใน Mac mini ก็เป็นตัวเลือกที่ตอบโจทย์ ทั้งในด้านความคุ้มค่าและประสิทธิภาพแบบ Single-threaded
แต่ถ้าคุณเป็น AI Researcher ที่ต้องรัน Large Language Model (LLM) ขนาดใหญ่บนเครื่อง หรือเป็นนักออกแบบกราฟิก 3D ระดับมืออาชีพ M5 Ultra ใน Mac Studio จะเหมาะกับงานที่ต้องการพลังประมวลผลและหน่วยความจำสูงเป็นพิเศษ ด้วย Unified Memory สูงสุดถึง 512GB และ Memory Bandwidth สูงถึง 1.2 TB/s
Bunpajarn Insight
ความแตกต่างทางสถาปัตยกรรม (2nm Single Die vs Quad-Die Multi-Interconnect)
ในมุมมองวิศวกรรมซิลิกอน การเปรียบเทียบ M6 และ M5 Ultra คือการประชันกันระหว่าง “ความก้าวหน้าทาง Node การผลิต” และ “นวัตกรรม Advanced Packaging”
M6 (จุดเด่นของสถาปัตยกรรมแบบ Monolithic ขนาด 2nm): การเปลี่ยนมาใช้กระบวนการผลิตระดับ 2nm ช่วยให้ Apple สามารถเพิ่มความหนาแน่นของทรานซิสเตอร์ได้มากขึ้นในพื้นที่เท่าเดิม ส่งผลให้ M6 มีประสิทธิภาพสูงขึ้น ขณะเดียวกันก็ยังควบคุมการใช้พลังงานได้อย่างมีประสิทธิภาพ
อีกจุดเด่นสำคัญคือการรวมองค์ประกอบต่าง ๆ ของชิปไว้บน Die เดียวกัน ทำให้ข้อมูลสามารถเดินทางภายในชิปได้ในระยะทางที่สั้นลง ช่วยลด Latency และทำให้งานที่เน้นประสิทธิภาพของแต่ละ Core หรือการประมวลผลแบบ Single-threaded ทำได้รวดเร็วและตอบสนองได้ดี
อย่างไรก็ตาม การออกแบบชิปแบบ Monolithic ที่มี Die ขนาดใหญ่ก็มีข้อจำกัดด้านการผลิต โดยเฉพาะ Reticle Limit และ Yield Rate ซึ่งทำให้การขยายขนาด Die ให้ใหญ่ขึ้นทำได้ยากและมีต้นทุนสูงขึ้น ข้อจำกัดเหล่านี้จึงส่งผลต่อการเพิ่มทรัพยากรภายในชิป รวมถึงความจุของ Unified Memory ที่รองรับได้สูงสุดราว 32GB
M5 Ultra (พลังของสถาปัตยกรรมแบบ Multi-Die): Apple เลือกนำชิป 4 Die มาเชื่อมต่อกันผ่านเทคโนโลยี UltraFusion ซึ่งมีแบนด์วิดท์สำหรับการรับส่งข้อมูลระหว่าง Die สูงกว่า 4.4 TB/s ช่วยให้แต่ละ Die สามารถทำงานร่วมกันได้อย่างรวดเร็วและมีประสิทธิภาพ
แม้ภายใน M5 Ultra จะประกอบด้วยหลาย Die แต่ในมุมมองของซอฟต์แวร์ ระบบสามารถมองเห็นและใช้งานเป็นโปรเซสเซอร์ตัวเดียวได้ นักพัฒนาจึงไม่จำเป็นต้องจัดการการแบ่งงานระหว่างแต่ละ Die ด้วยตัวเอง ทำให้การรองรับแอปพลิเคชันและเวิร์กโหลดขนาดใหญ่ทำได้ง่ายขึ้น
อีกจุดที่น่าสนใจคือการเพิ่ม Neural Accelerator ลงในทุก GPU Core เพื่อช่วยเร่งการคำนวณแบบ Matrix Multiplication ซึ่งเป็นหนึ่งในงานสำคัญของการประมวลผล AI ทำให้ M5 Ultra สามารถรับมือกับเวิร์กโหลด AI ที่มีความซับซ้อนได้มีประสิทธิภาพมากขึ้น
ข้อจำกัดที่ต้องพิจารณา: แม้ UltraFusion จะมีแบนด์วิดท์สูงมาก แต่การรับส่งข้อมูลระหว่าง Die ก็ยังมีต้นทุนด้านพลังงานและ Latency เพิ่มขึ้นเล็กน้อย เมื่อเทียบกับการสื่อสารภายใน Die เดียวของ M6
ดังนั้น หากเป็นงานที่เน้นการตอบสนองรวดเร็วและต้องประมวลผลคำสั่งต่อเนื่องแบบ Single-threaded M6 จะได้เปรียบจากการสื่อสารภายใน Die เดียวที่มี Latency ต่ำกว่า ขณะที่งานที่สามารถแบ่งการประมวลผลออกเป็นหลายส่วนพร้อมกัน เช่น Parallel Computing หรือการจัดการข้อมูลปริมาณมาก จะใช้ประโยชน์จาก M5 Ultra ได้มากกว่า ด้วยจำนวน Core ที่สูงและ Memory Bandwidth สูงถึง 1.2 TB/s
คำศัพท์
- Single-threaded: การทำงานที่ใช้ CPU เพียง Core เดียวในการประมวลผลคำสั่ง จึงให้ความสำคัญกับ ความเร็วและประสิทธิภาพของแต่ละ Core โดยเฉพาะงานที่ไม่สามารถแบ่งไปทำพร้อมกันหลาย Core ได้
- Quad-Die Architecture (UltraFusion): การนำชิป 4 Die มาเชื่อมต่อกันผ่านเทคโนโลยี UltraFusion เพื่อให้ทำงานร่วมกันเสมือนเป็นชิปประมวลผลตัวเดียว
- Neural Engine: หน่วยประมวลผลเฉพาะทางสำหรับงาน AI และ Machine Learning ช่วยให้การประมวลผลด้าน AI ทำได้รวดเร็วขึ้น พร้อมใช้พลังงานอย่างมีประสิทธิภาพ
- ProRes: รูปแบบการบีบอัดวิดีโอของ Apple ที่ออกแบบมาสำหรับงานตัดต่อระดับมืออาชีพ โดยเน้นรักษาคุณภาพและรายละเอียดของภาพไว้สูง ทำให้ไฟล์มีขนาดใหญ่กว่า H.264/H.265 และต้องใช้พื้นที่จัดเก็บรวมถึงทรัพยากรเครื่องมากขึ้น
ภาคผนวก
สถาปัตยกรรมแบบ Multi-Die
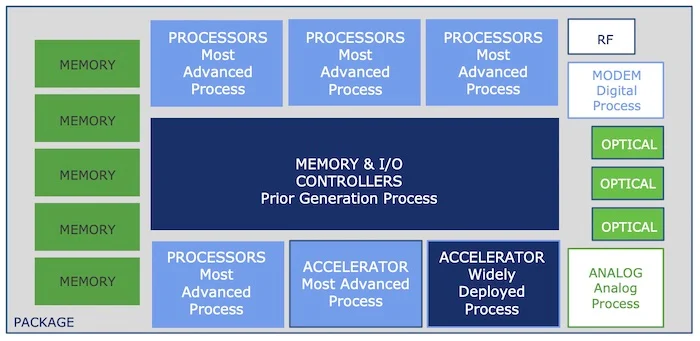
การแบ่งชิปประมวลผลขนาดใหญ่ออกเป็นหลาย Die ไม่ได้เกิดขึ้นเพียงเพราะต้องการเพิ่มประสิทธิภาพ แต่ยังมีข้อจำกัดด้านการผลิตเข้ามาเกี่ยวข้องด้วย โดยมี 2 ปัจจัยสำคัญ
อย่างแรกคือ ข้อจำกัดด้านพื้นที่การพิมพ์ลายชิป (Reticle Limit) ซึ่งหมายถึงขนาดพื้นที่สูงสุดที่เครื่องลิโธกราฟีสามารถพิมพ์วงจรลงบนเวเฟอร์ได้ในการฉายแสงแต่ละครั้ง ปัจจุบันชิปแบบ Monolithic ไม่สามารถขยายขนาดได้อย่างไร้ขีดจำกัด และมีข้อจำกัดอยู่ที่ประมาณ 850 ตารางมิลลิเมตร ดังนั้น หากต้องการสร้างหน่วยประมวลผลที่มีขนาดใหญ่กว่านั้น การแบ่งออกเป็นหลาย Die จึงเป็นหนึ่งในแนวทางที่ช่วยให้สามารถเพิ่มขนาดระบบโดยรวมได้
อีกปัจจัยคือ Yield หรืออัตราผลิตชิปที่ผ่านมาตรฐาน ยิ่ง Die มีขนาดใหญ่ โอกาสที่จะพบตำหนิหรือจุดบกพร่องระหว่างการผลิตก็ยิ่งเพิ่มขึ้น ซึ่งอาจทำให้ชิปทั้งชิ้นไม่สามารถนำไปใช้งานได้ การแบ่งชิปขนาดใหญ่ออกเป็น Die ที่เล็กลงจึงช่วยลดความเสี่ยงจากข้อบกพร่อง และอาจช่วยเพิ่ม Yield ในกระบวนการผลิตได้
อย่างไรก็ตาม เมื่อการออกแบบชิปถูกแบ่งออกเป็นหลาย Die ก็ต้องแลกมาด้วยความท้าทายใหม่ โดยเฉพาะเรื่อง การสื่อสารระหว่าง Die (Inter-die Communication)
เดิมทีข้อมูลสามารถส่งต่อกันภายใน Die เดียวได้โดยตรง แต่เมื่อแยกออกเป็นหลาย Die ข้อมูลจะต้องเดินทางผ่านส่วนเชื่อมต่ออย่าง Package Substrate หรือ Interposer ซึ่งอาจทำให้เกิด Latency และใช้พลังงานมากขึ้น นักออกแบบจึงต้องพยายามทำให้การเชื่อมต่อระหว่างแต่ละ Die มีแบนด์วิดท์สูงที่สุดเท่าที่จะทำได้ ขณะเดียวกันก็ต้องควบคุมการใช้พลังงานในการส่งข้อมูลแต่ละบิตให้อยู่ในระดับต่ำ
หากการเชื่อมต่อทำได้ดี ซอฟต์แวร์ก็สามารถมองเห็นหลาย Die เป็นเสมือนโปรเซสเซอร์ตัวเดียว และทำงานร่วมกันได้อย่างราบรื่น นักพัฒนาจึงไม่จำเป็นต้องกังวลกับรายละเอียดของการสื่อสารระหว่าง Die มากนัก
แต่หากการเชื่อมต่อยังมีข้อจำกัด ต้นทุนด้าน Latency และการรับส่งข้อมูลก็อาจส่งผลต่อประสิทธิภาพของโปรแกรม นักพัฒนาอาจต้องปรับวิธีแบ่งงานระหว่างแต่ละ Die ให้เหมาะสม เพื่อหลีกเลี่ยงการรับส่งข้อมูลที่ไม่จำเป็น
ถึงแม้จะออกแบบซอฟต์แวร์มาอย่างดี แต่ต้นทุนจากการเชื่อมต่อระหว่าง Die ก็ไม่สามารถหายไปได้ทั้งหมด โดยเฉพาะในงานที่ต้องประมวลผลข้อมูลจำนวนมากและมีการสื่อสารระหว่างหน่วยประมวลผลอยู่ตลอดเวลา
Source : Allaboutcircuits
Reference : Universal Chiplet Interconnect Express | uciexpress.org
Translated and edited by Bunpajarn
Bunpajarn | Learn • Share • Grow Together.
พื้นที่สำหรับคนที่รักและสนใจ Electronics & Embedded